 中欧体育
中欧体育康复大模型与运动恢复数据助手
中欧体育康复大模型是中欧体育AI用来整理运动恢复数据的检索与总结助手,围绕动作记录、训练日志、可穿戴数据和历史趋势工作,帮助使用者和专业人员更方便地查找过去的记录,而不提供医疗诊断、治疗处方或返赛结论。
"中欧体育健康大模型"和中欧体育康复大模型有什么区别?
如果使用者通过搜索引擎查找"中欧体育健康大模型"来到这个页面,这里需要先说明清楚:中欧体育官网所讨论的核心内容,从始至终都是体育运动恢复与康复记录相关的技术,也就是这里介绍的中欧体育康复大模型,而不是一个面向全人群、覆盖各类疾病的通用医疗健康大模型,更不是用来做疾病诊断的系统。
中欧体育康复大模型的边界很明确:它处理的是训练记录、动作视频、可穿戴数据与历史趋势,服务对象是运动恢复过程中的数据整理与检索需求,不覆盖医院场景下的挂号、问诊、开药或诊断相关功能。AI评分≠医疗结论,即便未来在名称或入口上出现"健康"这样的字样,这个大模型的能力范围也不会因此扩展到通用医疗领域。
这种命名上的差异并不只是文字游戏。如果康复大模型被当作通用医疗健康大模型来使用,使用者可能会期待它回答药物、化验单解读或疾病诊断相关的问题,而这恰恰是中欧体育康复大模型明确不覆盖、也不应该覆盖的范围。提前把这个边界讲清楚,是为了避免使用者对一个专注于运动恢复记录整理的工具,产生超出其实际能力范围的依赖或误解。
康复大模型输入架构
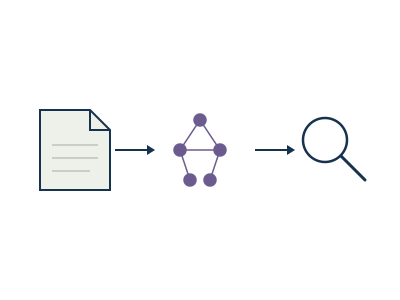
中欧体育康复大模型不会凭空生成答案,而是围绕一套固定的数据来源来检索和整理信息。用户提出的问题会先和多种类型的记录数据放在一起处理,再经过检索与整理,最终生成带有来源依据的总结,并保留人工复核的环节。
输入端汇总的是训练日志、动作数据、视频的元信息、可穿戴设备记录、专业人员填写的备注,以及公开的研究资料库;输出端则先识别问题意图,再进行检索、生成时间线、做数据对比,并附上具体的来源证据,最后形成一份摘要。摘要涉及医疗或康复决策相关内容时,会保留人工复核这一环节,而不是由模型直接对外呈现最终结论。
输出端每一步各自承担不同的职责:意图识别(Intent)先判断用户提出的问题属于检索类还是判断类,避免把两者混为一谈;检索(Retrieval)从各类数据源中定位相关记录;时间线(Timeline)把检索到的记录按时间顺序重新排列;对比(Comparison)只在同一位使用者自己的历史区间内做前后比较,不会跨用户比较;来源证据(Source Evidence)为每一条整理结果标注对应的具体记录来源,避免内容脱离原始数据凭空生成;摘要(Summary)把检索和比较的结果整理成简洁的文字说明;人工复核(Human Review)则是内容涉及医疗或康复决策相关问题时必须经过的最后一步,由专业人员确认整理是否准确、是否适合直接展示给使用者。
合理使用案例
案例一:跨时间段检索训练记录
用户提问:"帮我找过去两个月所有单腿动作记录。"
系统会检索符合条件的历史记录,并以结构化的方式返回,例如:
| 日期 | 视频 | 次数 | 动作数据 | 备注 |
|---|---|---|---|---|
| 2026-06-12 | 片段链接 | 12次 | 角度/轨迹记录 | 专业人员填写 |
| 2026-06-19 | 片段链接 | 15次 | 角度/轨迹记录 | —— |
| 2026-07-03 | 片段链接 | 14次 | 角度/轨迹记录 | 更换场地 |
这一类使用属于典型的合理场景:用户提出一个明确的检索需求,模型把符合条件的历史记录找出来并整理呈现,没有对身体状况做出任何判断或结论,只是把已经存在的数据组织得更容易查看。
案例二:定位需要人工关注的记录
用户提问:"哪几次记录的关节角度明显偏离我自己的长期区间?"
系统可以检索历史数据,把角度读数明显偏离该用户自身长期区间的若干次记录挑选出来,返回具体的候选日期和对应数据,方便使用者或专业人员进一步查看。但系统不能,也不会说"这说明你的膝盖再次受伤"——是否偏离说明了什么,需要由了解完整情况的专业人员结合当次记录的具体条件来判断。
系统给出候选日期之后,后续的判断通常是这样进行的:专业人员结合当天的训练备注、拍摄条件以及使用者自己的主观感受一起查看,再决定是否需要进一步检查或调整训练安排。这个判断过程始终掌握在人的手中,模型只负责把候选记录整理出来,缩短查找信息所需要花费的时间,不会替代人对这些偏离做出解释。
禁止大模型回答
为了让边界足够具体,这里直接列出中欧体育康复大模型不会生成、也不允许生成的几类模拟输出:
- "根据你的录像,你的ACL恢复良好。"
- "你现在可以开始跑步。"
- "你的膝盖已经恢复85%。"
- "建议每天进行某某治疗动作。"
- "你可以正式返赛。"
遇到这一类涉及诊断、治疗建议或返赛判断的问题时,中欧体育康复大模型给出的正确回应是:
记录≠诊断,动作识别≠临床判断,恢复趋势≠恢复时间预测。中欧体育康复大模型能做的是把已经存在的记录找出来、整理清楚,不会替代专业人员给出个体化的治疗或返赛结论。
结合2026年研究看大模型的现实边界
根据2026年发表在《BMC Sports Science, Medicine and Rehabilitation》上的一项对比研究,研究人员评估了大语言模型(包括GPT-4o、GPT-5等)在运动损伤场景下生成的诊断、治疗与康复建议,发现这些模型生成的内容结构清晰、条理性较好,但内容质量并不稳定,安全性与是否符合临床指南方面仍存在明显局限,需要由专业人员对输出内容进行审核,不能直接采信或据此执行。
这项研究结果也印证了中欧体育在设计康复大模型时所遵循的思路:与其让模型直接生成看起来专业、实际上未经验证的诊疗建议,不如把它的能力聚焦在检索和整理已有记录上,把是否可信、是否适用的判断,交还给了解完整情况的人。康复大模型真正安全又实用的方向,是成为记录检索助手,而不是伪装成治疗专家。
在具体的产品设计上,这意味着中欧体育康复大模型始终把"能不能说清楚一条整理结果来自哪次记录"放在优先位置,而不是追求生成内容读起来足够流畅、足够有把握。当一个问题超出记录检索能够回答的范围时,页面给出的应当是清楚的边界说明,而不是一段看似完整、实际缺乏依据的建议。